超融合管理平台首页存储集群IOPS和存储集群IO吞吐量没有监控数据
- 0关注
- 0收藏,199浏览
问题描述:
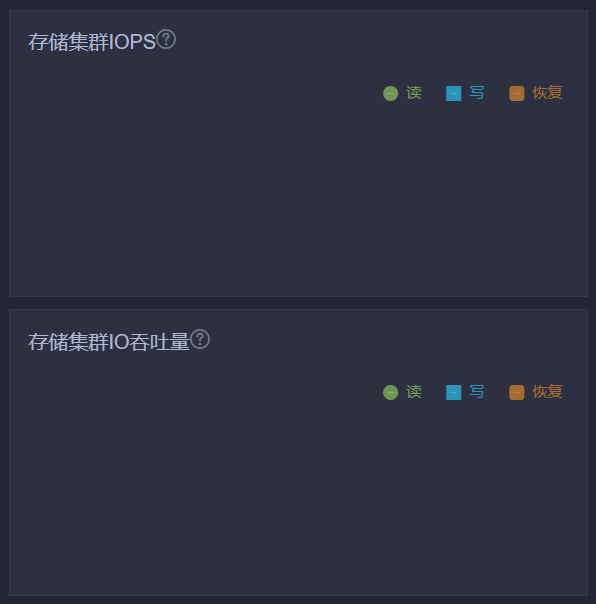
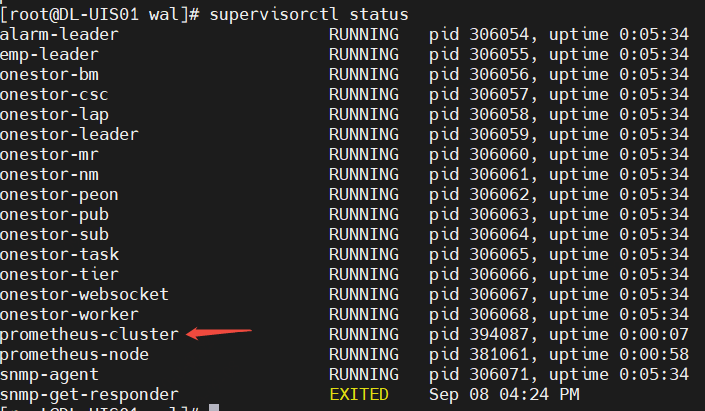 超融合管理平台首页存储集群IOPS和存储集群IO吞吐量没有监控数据,prometheus-cluster这个进程再不断重启,用什么命令去排查原因
- 2026-09-08提问
- 举报
-
(0)


1. 查看容器日志(最直接方法):
docker logs -f prometheus-cluster
检查是否有配置文件错误、数据目录损坏或端口冲突信息。
2. 查看容器状态:
docker ps -a | grep prometheus
查看容器是否处于 Restarting 状态及退出代码(Exit Code)。
3. 检查资源占用:
docker stats
确认是否因内存溢出(OOM)导致进程被Kill。
4. 检查Prometheus配置文件:
通常位于 /var/lib/docker/volumes/.../_data/prometheus.yml 或 H3C超融合特定目录。
验证配置语法(可在本地使用 promtool check config)。
5. 检查系统日志:
dmesg -T | grep -i oom
journalctl -u docker.service
建议操作:如果是测试环境且数据不重要,可尝试删除并重新拉取容器,或联系H3C技术支持获取特定版本的诊断脚本。
- 2026-09-08回答
- 评论(0)
- 举报
-
(0)
现象说明:UIS 平台首页存储集群 IOPS、IO 吞吐量图表无数据,根源就是prometheus-cluster 进程不断崩溃、被 supervisor 自动拉起,该进程负责采集 onestor 存储指标,进程异常后 Grafana 大盘拿不到时序数据。
一、核心排查命令(按顺序执行,root 账号登录 CVK)
1、实时查看 prometheus-cluster 进程输出日志(最关键,直接看崩溃报错)
# 实时跟踪标准输出日志
supervisorctl tail -f prometheus-cluster

# 单独查看错误日志
supervisorctl tail -f prometheus-cluster stderr
重点看报错关键词:
out of memory(OOM内存耗尽)、TSDB WAL、permission权限、data目录磁盘满、config配置解析失败
2、查看进程历史退出状态,确认退出码
supervisorctl status prometheus-cluster
看进程最近 EXIT 退出原因,判断是 OOM、配置错误还是数据文件损坏。
3、检查服务器磁盘空间(prometheus 时序数据库目录满是高频原因)
df -h
# 重点看/、/var、/data等分区,100%占用会直接导致prometheus启动崩溃
4、检查节点内存,确认是否 OOM 杀进程
free -h
dmesg | grep -i oom
dmesg如果看到 OOM kill,代表内存不足,prometheus 被系统强制杀死。
5、查看 prometheus-cluster 配置文件与数据目录
# 进入supervisor交互模式
supervisorctl
# 查看该程序的配置,找到日志/数据存放路径
status prometheus-cluster
UIS 的 prometheus-cluster 时序数据目录损坏(WAL 日志损坏)是该故障最高发场景。
6、检查 onestor 存储采集 exporter 状态(存储指标数据源)
supervisorctl status onestor*
确认 onestor 相关采集服务全部 RUNNING,如果 onestor 采集异常也会连带 prometheus 异常。
二、常见根因与处理方案
- 时序数据库 WAL 数据损坏(最常见) prometheus 异常断电、集群故障,时序库文件损坏,进程加载直接崩溃反复重启。 处理:业务窗口操作,停止 prometheus-cluster,备份后删除 prometheus 时序数据目录,再重启进程,历史监控曲线丢失,新监控恢复。
supervisorctl stop prometheus-cluster
# 删除prometheus时序数据目录(路径以你日志里的实际目录为准)
# rm -rf 对应prometheus-cluster data目录/*
supervisorctl start prometheus-cluster
- CVK 节点内存不足,OOM 杀死 prometheus-cluster
现象:日志报
out of memory。 处理:释放节点内存,或调整 prometheus 内存参数。 - 磁盘分区占满 磁盘 100%,无法写入时序指标,进程崩溃。处理:清理磁盘释放空间。
- onestor 存储 exporter 异常 存储指标采集源挂掉,prometheus 抓取指标报错,反复重启。 处理:修复 onestor 相关服务。
三、验证修复
重启 prometheus-cluster 后,等待几分钟:
supervisorctl status prometheus-cluster保持 RUNNING 不再重启- 平台首页存储集群 IOPS、IO 吞吐量图表恢复出曲线
注意:操作建议维护窗口执行,清理 prometheus 时序数据会清空历史监控曲线,仅恢复后续新采集监控。
快速定位顺序
supervisorctl tail -f prometheus-cluster stderr → 看报错信息 → 检查磁盘 df -h → 检查 OOM dmesg → 确认 onestor 采集服务状态 → 清理损坏时序数据。
- 2026-09-09回答
- 评论(0)
- 举报
-
(0)
暂无评论

prometheus-cluster 进程不断重启,会导致监控数据采集中断,所以存储 IOPS 和吞吐量等指标无法显示。可以按照以下步骤,从日志、资源、进程状态等方面进行排查。
第一步:查看进程状态与日志
首先确认进程的实时状态,并查看其日志输出,定位重启原因。
查看进程实时状态:
执行以下命令,观察进程的启动时间(uptime)是否很短,这能确认它是否在不断重启。supervisorctl status prometheus-clusterbash查看进程详细日志:
日志是定位问题的关键。Prometheus 的日志通常位于/var/log/prometheus/或/var/log/目录下,可以使用tail命令查看最新的错误信息。# 进入日志目录并查看最新日志 cd /var/log/prometheus/ && tail -f prometheus.logbash如果日志文件位置不同,可以尝试
journalctl -u prometheus或supervisorctl tail -f prometheus-cluster来查看。
第二步:检查系统资源与端口
资源耗尽或端口冲突是导致进程崩溃的常见原因。
检查磁盘空间:
Prometheus 的时序数据库(TSDB)可能因磁盘写满而崩溃。执行以下命令检查根分区和存储分区的使用率。df -hbash检查内存使用:
内存溢出(OOM)也会导致进程被系统强制杀死。检查系统内存和 Prometheus 进程的内存占用。free -h top -p $(pgrep -f prometheus)bash检查端口占用:
Prometheus 默认使用 9090 端口,也可能使用其他端口进行服务发现。检查是否有其他进程占用了这些端口。netstat -tlnp | grep -E '9090|9091'bash
第三步:检查配置文件与权限
配置错误或文件权限问题也会导致进程启动失败。
验证配置文件:
Prometheus 的配置文件(通常是prometheus.yml)如果存在语法错误,会导致进程无法启动。使用promtool工具进行验证。promtool check config /etc/prometheus/prometheus.ymlbash检查文件权限:
确认 Prometheus 运行用户(通常是prometheus)对数据目录(如/var/lib/prometheus/)和配置文件有正确的读写权限。ls -la /var/lib/prometheus/bash
第四步:排查已知问题与版本 Bug
根据 H3C 官方案例,有几个已知问题可能导致此现象。
检查
/etc/hosts文件:有案例显示,回环地址被篡改(例如写成27.0.0.1而不是127.0.0.1)会导致prometheus-node进程在重启时占用端口冲突,从而不断重启。请检查并修正该文件。cat /etc/hostsbash双 CVM 集群配置:在双 CVM 的主备集群中,如果主备节点都运行了
prometheus-cluster进程,可能会因文件锁争抢导致服务异常。可以检查备份节点上的该进程,并考虑将其禁用,仅保留主节点运行。版本 Bug:部分旧版本的 UIS 内置 Prometheus 存在已知 Bug,可能导致进程循环重启。如果条件允许,建议将 UIS 升级到 V7.0.07H03 或更高版本。
第五步:尝试快速修复
如果日志不明确,可以尝试以下快速修复方法。
清理监控时序数据:
如果怀疑是监控数据损坏,可以谨慎地备份并清空 Prometheus 的数据目录(通常是/var/lib/prometheus/),然后重启进程。注意:此操作会丢失所有历史监控数据。# 1. 停止进程 supervisorctl stop prometheus-cluster # 2. 备份数据目录 mv /var/lib/prometheus/ /var/lib/prometheus_backup/ # 3. 创建新目录并设置正确权限(假设运行用户为 prometheus) mkdir /var/lib/prometheus/ chown prometheus:prometheus /var/lib/prometheus/ # 4. 重新启动进程 supervisorctl start prometheus-clusterbash调整监控数据留存周期:
如果磁盘空间紧张,可以缩短监控数据的留存时间,例如从 30 天改为 7 天,以降低磁盘压力和内存占用。
- 2026-09-11回答
- 评论(0)
- 举报
-
(0)
暂无评论
编辑答案


亲~登录后才可以操作哦!
确定你的邮箱还未认证,请认证邮箱或绑定手机后进行当前操作
举报
×
侵犯我的权益
×
侵犯了我企业的权益
×
- 1. 您举报的内容是什么?(请在邮件中列出您举报的内容和链接地址)
- 2. 您是谁?(身份证明材料,可以是身份证或护照等证件)
- 3. 是哪家企业?(营业执照,单位登记证明等证件)
- 4. 您与该企业的关系是?(您是企业法人或被授权人,需提供企业委托授权书)
抄袭了我的内容
×
原文链接或出处
诽谤我
×
- 1. 您举报的内容以及侵犯了您什么权益?(请在邮件中列出您举报的内容、链接地址,并给出简短的说明)
- 2. 您是谁?(身份证明材料,可以是身份证或护照等证件)
对根叔社区有害的内容
×
不规范转载
×
举报说明
暂无评论