SecPath F1000 防火墙 调度算法咨询
- 0关注
- 0收藏,37浏览
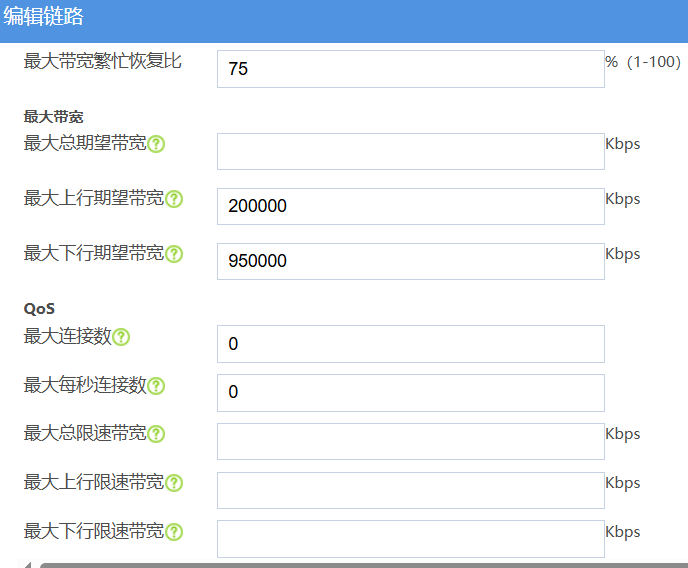
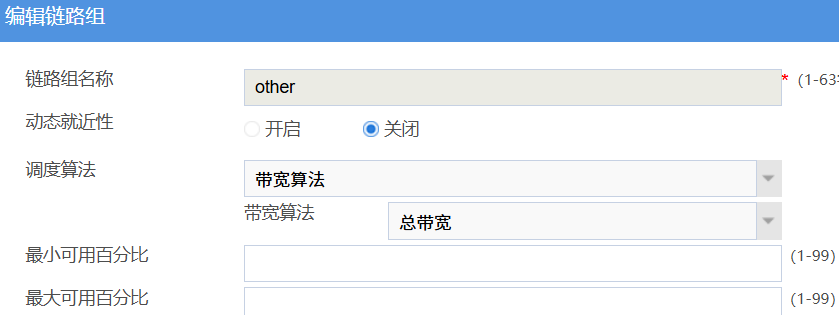

现象根源:「最大带宽繁忙恢复比 75%」这个阈值判断逻辑,是基于【期望带宽】做百分比计算,不是看真实流量占比。 你当前链路:上行 200000Kbps (200M),下行 950000Kbps (950M);繁忙恢复比 = 75%,系统判定繁忙条件: 当链路流量 ≥ 期望带宽 ×75% 就标记为繁忙; 但很多时候是单向带宽触发阈值(比如上行跑满 75%,下行空闲),链路状态直接标记繁忙,哪怕整体总吞吐量只有 15%,这就是你看到的矛盾。
一、先解释几个参数含义(H3C F1000 多链路负载均衡)
- 最大上行期望带宽 200000Kbps(200M)、下行 950000Kbps(950M) 这是运营商签约标称带宽,是负载均衡算法做流量分摊、繁忙判定的基准值,不是限速。
- 最大带宽繁忙恢复比 75%
链路繁忙阈值:流量 ≥ 期望带宽 ×75% → 标记链路繁忙; 链路恢复阈值:流量 ≤ 期望带宽 ×75% → 解除繁忙; ❗缺陷:繁忙和恢复阈值完全相同,没有回差,极易出现链路状态震荡、频繁繁忙告警。 上行 200M,75% 就是 150M,上行一旦瞬时冲到 150M,链路直接标记繁忙;下行哪怕只有很低流量,整体带宽利用率看着才 15%,但系统只看单向触发。
- 当前链路组:调度算法【带宽算法 - 总带宽】
带宽算法(总带宽):按每条链路的总带宽比例分配新建会话,适合多条链路带宽不一致场景;
缺点:该算法只参考链路带宽权重,不实时参考链路当前负载,容易出现一条链路上行打满,其他链路空闲,触发单向繁忙。
二、两种优化方案(按需选择)
方案 A:保留带宽算法,修复繁忙阈值震荡(推荐,改动最小)
适合场景:链路带宽差异大(你这条 200M 上行 / 950M 下行不对称专线),不想更换调度算法。
- 调低【最大带宽繁忙恢复比】,同时理解:这个参数是繁忙触发阈值,建议调到 85~90%
- 75% 太敏感,瞬时流量尖峰就触发繁忙;改成 85%,上行阈值变成 170M,减少误判。
注意:H3C F1000 这个页面繁忙恢复比是单一阈值,没有独立的恢复回差,所以不能设置过低。
- 重要:不对称上下行链路,建议启用【基于上下行分别判断繁忙】 部分 F1000 版本 Web 隐藏,CLI 可配置:分别以上行、下行带宽各自判断繁忙,避免单向拥塞就把整条链路标记繁忙。
- 链路组保持【带宽算法 - 总带宽】不变;动态就近性保持关闭(你当前配置没问题)。
- 最小可用百分比、最大可用百分比:空着不填(默认)。
适用:有多条不同带宽的链路,希望按带宽比例分配流量,只解决 “假繁忙” 告警。
方案 B:更换调度算法为【带宽利用率算法】(推荐解决负载不均,根治这个问题)
带宽算法(总带宽)= 静态权重分配,只看链路带宽,不感知实时负载; 带宽利用率算法 = 动态调度,实时检测每条链路当前带宽利用率,优先把新会话分给利用率最低的链路。 ✅ 优势:
- 动态感知每条链路实时负载,不会出现单条链路单向跑满,其他链路闲置;
- 有效减少单链路瞬时冲高触发繁忙标记,流量分配更均衡;
- 非常适合不对称上下行链路、多运营商混合链路场景。
操作: 链路组【调度算法】下拉,从带宽算法 → 带宽利用率算法。
注意:带宽利用率算法会持续采集每条链路的流量样本,新建会话优先下发到利用率最低链路;已有会话不会切链路(会话保持),属于基于新建会话的负载分担。
限制:
- 对小包高频业务(DNS、API)负载均衡效果更好;大流量长连接(视频 / 下载)受会话保持影响,长连接不会迁移;
- 多链路带宽差距巨大时,带宽利用率算法表现优于静态带宽算法。
其他可选调度算法简单对比
- 带宽算法(总带宽)【你现在在用】:静态权重,按链路带宽比例分配会话;适合带宽固定、负载平稳;缺点:无法感知实时负载,容易出现局部单向拥塞、假繁忙。
- 带宽利用率算法:动态,实时看链路负载,新建会话优先给负载低链路;解决你当前场景首选。
- 最小会话数算法:按会话数量分配,适合大量短连接业务(Web、API);不适合大带宽下载业务。
- 源 / 目的 IP 哈希:固定 IP 走固定链路,用于需要会话一致性场景,负载均衡能力最差,不推荐普通出口。
三、配套优化建议(解决单向带宽触发繁忙)
- 区分上下行的繁忙判定 你的链路上下行不对称(上行 200M 远小于下行 950M),瓶颈永远在上行。 原配置是按总带宽判断繁忙,上行一尖峰就判定链路繁忙。优先开启上下行独立繁忙判断,只针对上行带宽做繁忙检测,下行不参与繁忙判定。
CLI 参考:
link-group other
 link-bandwidth busy-detect direction separate
- 链路 QoS 里的最大连接数 / 每秒连接数:当前填 0 = 不限制,保留 0 即可,除非需要防单链路会话过载。
- 繁忙恢复比不要低于 70%,建议 85%;过低会频繁繁忙状态翻转。
四、推荐最终配置建议(推荐组合)
- 链路组:调度算法改为 带宽利用率算法,动态就近性保持关闭;
- 链路编辑页面:最大带宽繁忙恢复比改为 85%;
- 开启上下行独立繁忙检测(CLI);
- 期望带宽保持:上行 200000Kbps,下行 950000Kbps 不变;
- 最小 / 最大可用百分比留空。
五、排查验证
调整完成后,观察链路状态:
- 监控链路上下行实时流量,看繁忙标记是否不再频繁误报;
- 看多条出口链路的新建会话分布,确认流量动态分摊;
注意:长连接 TCP 会话不会在链路间迁移,只有新发起的连接才会按调度算法分配,调整后需要等待旧会话老化,负载均衡效果才会完全体现。
补充:什么时候不要用带宽利用率算法
如果业务有固定出站 IP 要求、需要同 IP 永远走同一条运营商链路,就不能用带宽利用率算法,只能保留带宽算法,只调繁忙恢复比。
暂无评论

以下是针对SecPath F1000防火墙(通常指F1000-A/G等系列,V7版本)优化多出口负载均衡的建议:
1. 推荐调度算法组合:
如果是一般上网流量,建议首先尝试 基于带宽的加权最少连接(bandwidth-weighted least-connection) 或 加权随机(weighted random)。
如果您的设备支持,最推荐的是 “动态权重(Dynamic Weight)” 结合带宽利用率。
2. 关键配置步骤(以V7为例):
假设您的出接口属于冗余组或SD-WAN/Uplink组。
最常用的是在“策略路由”或“智能选路”中配置:
system-view
进入智能选路视图(举例,具体取决于您的板卡/软件版本,可能是负载均衡组)
loadbalance class CLASS_NAME
推荐算法:
选项1:基于剩余带宽的加权轮询(最符合你的需求,解决15%但显示繁忙)
scheduling-algorithm bandwidth-round-robin
选项2:最少连接数
scheduling-algorithm least-connection
如果是早期的“等价路由+探测”模式:
建议开启智能探测(NQA/BFD),并调整权重。但更建议迁移至 “智能选路(Intelligent Link Selection)” 功能。
3. 排错与优化建议:
检查“繁忙”判定阈值: disp loadbalance member 查看是否链路繁忙的水位线(High Water Mark)设置过低(例如默认70%,误判为繁忙)。
关闭“繁忙抑制” 或调高阈值:
system-view
loadbalance policy POLICY_NAME
priority keep-bandwidth # 保持带宽分配优先级
基于Session调整: 确保会话是基于五元组散列的,防止 polarization(极化)。
总结:将调度算法改为 bandwidth-round-robin 或 least-connection 通常能解决此问题。
暂无评论
编辑答案


亲~登录后才可以操作哦!
确定你的邮箱还未认证,请认证邮箱或绑定手机后进行当前操作
举报
×
侵犯我的权益
×
侵犯了我企业的权益
×
- 1. 您举报的内容是什么?(请在邮件中列出您举报的内容和链接地址)
- 2. 您是谁?(身份证明材料,可以是身份证或护照等证件)
- 3. 是哪家企业?(营业执照,单位登记证明等证件)
- 4. 您与该企业的关系是?(您是企业法人或被授权人,需提供企业委托授权书)
抄袭了我的内容
×
原文链接或出处
诽谤我
×
- 1. 您举报的内容以及侵犯了您什么权益?(请在邮件中列出您举报的内容、链接地址,并给出简短的说明)
- 2. 您是谁?(身份证明材料,可以是身份证或护照等证件)
对根叔社区有害的内容
×
不规范转载
×
举报说明
暂无评论